O que é a Aura?
A Aura é um assistente de IA local, em português, com interface visual, voz e um avatar animado. Eu a criei para ajudar nas tarefas do dia a dia e para testar na prática como juntar um modelo de linguagem local com um sistema que executa ações de verdade.
Ela roda inteira na minha máquina: a interface em React, a API em Python e os dados no PostgreSQL. A conversa usa o Ollama, que executa o modelo de linguagem localmente.
Em resumo
- Status
- Em desenvolvimento
- Onde roda
- No meu computador
- Idioma
- Português
- Interface
- Voz, texto e avatar animado
- Conversa
- Ollama, Nemotron 8B quantizado
- Dados
- PostgreSQL
Principais características
- Conversa por texto ou por voz, em português
- Resposta falada, com um avatar que acompanha a fala
- Lista de compras e catálogo de produtos com códigos de barras
- Clima, estado do computador e resumo do dia
- Ações executadas por regras fixas, cada uma com um recibo
- Dados guardados em um banco PostgreSQL local
Por que construir um assistente local?
Três motivos me levaram a montar a Aura em vez de usar um assistente pronto.
- Privacidade. A conversa passa por um modelo que roda na minha máquina e fica salva no meu banco de dados.
- Controle. Eu decido o que o assistente pode fazer, e cada ação passa por um código que eu escrevo e testo.
- Aprendizado. Montar o sistema inteiro, da voz ao banco de dados, mostra onde um assistente de IA funciona bem e onde precisa de limites.
Se você quer montar a base de uma IA local, veja O que é Ollama e como instalar.
O que a Aura faz hoje
Conversa por texto e voz
Posso escrever ou falar. A conversa livre vai para o modelo local, e o histórico fica salvo no PostgreSQL, ligado à minha conta.
Lista de compras
Peço para adicionar ou remover um item, por nome ou por número, e a Aura executa. Se o pedido vem incompleto, ela pergunta qual item. A tela permite remover com confirmação e exportar a lista em PDF. O vídeo no topo da página mostra esse fluxo.
Catálogo de produtos e códigos de barras
- Busca por nome, marca, categoria e apelidos
- Variantes e embalagens de cada produto
- Scanner de código de barras pela câmera do celular, com digitação manual como alternativa
- Códigos de barras nunca são apagados, apenas desativados
- Se eu adiciono à lista um produto que não está no catálogo, a Aura pergunta se deve criá-lo e só grava depois de um "sim"
Clima
Mostra o tempo atual e a previsão de três dias, com temperatura, sensação térmica, umidade e vento. Os dados vêm da Open-Meteo, e a localização só é pedida quando é necessária.
Estado do computador
Um painel somente leitura mostra processador, memória, disco, tempo ligado e a placa de vídeo NVIDIA, quando existe. Ele não lista processos nem mostra configurações secretas.
Agentes e resumo do dia
Um painel mostra agentes e tarefas recentes, com estado (na fila, em execução, finalizada ou com falha) e progresso. O resumo do dia é falado: a Aura conta o que está em execução e o que espera na fila. Ainda não existe um executor que rode essas tarefas sozinho, e isso está na lista do que falta.
Voz e rosto: como a Aura ouve e fala
Como ela ouve
O áudio passa primeiro pelo Vosk, que transcreve em português. Quando a fala é livre, não é reconhecida ou precisa de confirmação, entra o faster-whisper (modelo small, na CPU com int8). Em ações que mudam dados, as duas transcrições precisam concordar. Se discordam, a Aura não executa.
Como ela fala
A resposta é sintetizada localmente com o Phonon, na voz Isadora em português, e o Piper fica como reserva. Antes de falar, o texto passa por um validador que prepara números, percentuais, datas e horários para a pronúncia, sem alterar o que aparece na tela.
A licença do Phonon (CC BY-NC 4.0) não permite uso comercial. Por isso essa voz é de uso pessoal.
O avatar
O rosto é um desenho em SVG, com estados visuais como ausente e ociosa, e acompanha a reprodução da voz. Antes de abrir uma tela, a Aura anuncia o que vai fazer. Depois de mostrar o resultado, lê um resumo.
O modelo conversa, o código age
Esta é a decisão central do projeto. O modelo de linguagem não executa ferramentas e não acessa o banco de dados. Pedidos como adicionar ou remover um item são reconhecidos por regras fixas e executados pelo backend, que valida o pedido e devolve um recibo: feito, nada alterado ou item não encontrado.
Eu falo ou digito
   │
   ├─ Pedido de ação (lista, catálogo, clima, sistema)
   │     └─ Regras fixas → backend valida → PostgreSQL → recibo → Aura narra
   │
   └─ Conversa livre
         └─ Ollama (modelo local) → resposta falada
Por que não deixar o modelo executar as ações?
- O resultado é previsível: o mesmo pedido gera a mesma ação.
- Cada ação pode ser validada e testada como qualquer outro código.
- A Aura não diz que fez algo que não aconteceu, porque a resposta vem do recibo do backend.
- Ações que criam dados, como cadastrar um produto, exigem confirmação explícita.
O modelo continua responsável pela conversa livre.
Arquitetura e tecnologias
Aura
 ├── Interface   React 18 + Vite, avatar em SVG
 ├── API         Python + FastAPI
 ├── Dados       PostgreSQL
 ├── Conversa    Ollama (Nemotron 8B quantizado, na RAM)
 ├── Voz         Vosk + faster-whisper (entrada), Phonon + Piper (saída)
 └── Clima       Open-Meteo
| Camada | Tecnologia | Papel |
|---|---|---|
| Interface | React 18 e Vite | Telas, avatar em SVG e narração |
| API | Python e FastAPI | Endpoints, validação e regras de ação |
| Dados | PostgreSQL | Lista, catálogo, conversas e tarefas |
| Conversa | Ollama com Nemotron 8B quantizado | Modelo de linguagem local, executado na memória RAM |
| Entrada de voz | Vosk e faster-whisper | Transcrição em português, 100% em CPU (int8) |
| Saída de voz | Phonon e Piper | Síntese de fala local |
| Clima | Open-Meteo | Tempo atual e previsão |
O módulo de produtos segue camadas bem separadas: rotas, controladores, serviços e repositórios. Cada camada fala apenas com a seguinte.
Hardware real: um notebook com GPU de 2 GB
Tudo o que você viu no vídeo roda em um notebook comum, sem servidor e sem placa de vídeo moderna. Vale mostrar a máquina e explicar o que ela impôs ao projeto, porque várias decisões da Aura nasceram desses limites.
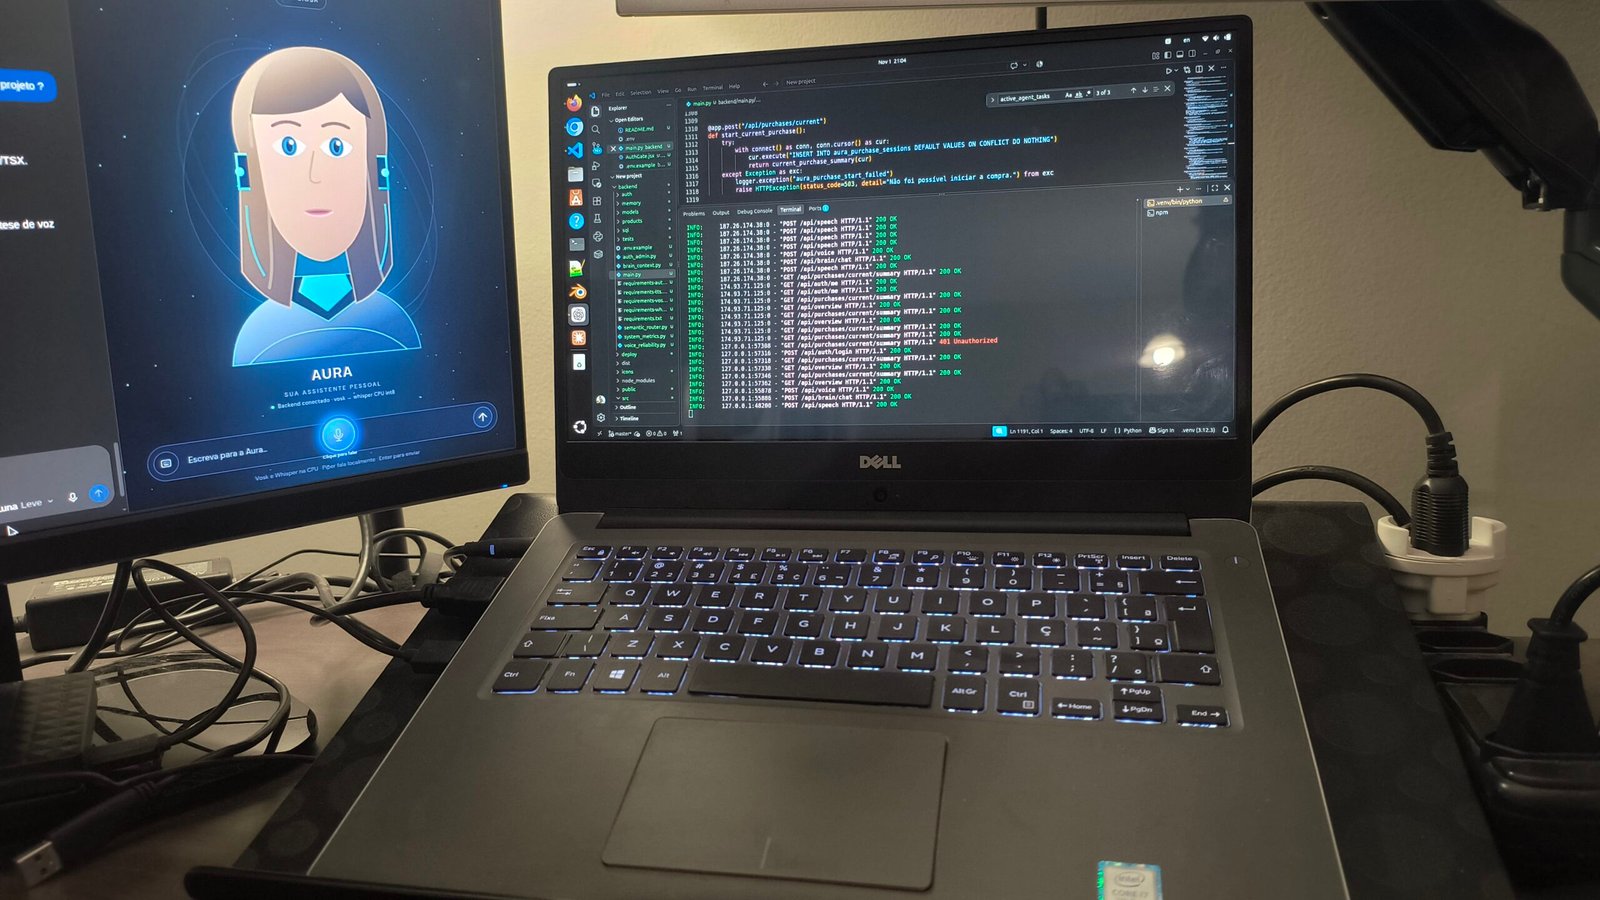
Especificações
- Processador
- Intel Core i7 de 7ª geração, 4 núcleos e 8 threads
- Memória RAM
- 16 GB DDR4
- Sistema operacional
- Ubuntu Linux
- GPU
- NVIDIA GeForce 940MX, 2 GB de VRAM (arquitetura legada)
O que o hardware decidiu
| Tarefa | Limite do hardware | Decisão na Aura |
|---|---|---|
| Transcrição de voz | 2 GB de VRAM não comportam o Whisper na GPU | Vosk e faster-whisper (modelo small, quantização int8), 100% na CPU |
| Conversa livre | A GPU não comporta um modelo de 8 bilhões de parâmetros | Nemotron 8B quantizado, executado pelo Ollama na memória RAM |
| Síntese de fala | Sem GPU disponível para outras cargas | Phonon e Piper, locais, compartilhando a CPU |
Em resumo: a GPU de 2 GB ficou de fora do pipeline de IA, e a CPU com a RAM de 16 GB faz todo o trabalho. A quantização é o que torna isso viável. Um modelo de 8 bilhões de parâmetros quantizado ocupa poucos gigabytes e cabe na memória do sistema, e o faster-whisper em int8 reduz o custo da transcrição na CPU.
Por que a Aura demora no estado "pensando"
Na demonstração em vídeo, há uma pausa visível no estado "pensando". Ela não é um efeito de edição nem um defeito de código: é a contenção de CPU. Transcrição, modelo de linguagem e síntese de voz disputam os mesmos 4 núcleos, e a conversa livre é a etapa mais pesada. Ações como mexer na lista de compras passam por regras fixas, sem o modelo, e por isso são rápidas.
Prefiro mostrar essa latência como ela é. Ela mostra que um assistente de IA privado, em português e com voz, não exige cluster, servidor dedicado ou placa de vídeo cara. Hardware melhor deixaria a Aura mais rápida, mas o projeto funciona sem ele.
Segurança e privacidade
A Aura tem login próprio. As senhas ficam guardadas com hash Argon2, a sessão expira em oito horas e pode ser encerrada pelo logout. Requisições que alteram dados exigem um token contra requisições forjadas, e os logs não guardam conteúdo de fala nem configurações secretas.
O que sai da minha máquina
A conversa e os dados ficam locais. Há duas exceções: o clima, que consulta a Open-Meteo com as coordenadas do navegador, e o primeiro download do modelo de voz, que precisa de acesso ao Hugging Face.
Feita para uma pessoa só
A instalação atual é pessoal. A lista e as tarefas ainda não são separadas por usuário, então a Aura não está pronta para várias contas.
IA local ou assistente na nuvem?
Aura (local)
Vantagens
- Conversa e dados ficam na minha máquina
- Eu controlo o que cada ação faz
- Feita para o meu fluxo, em português
Limites
- Exige instalação e manutenção
- O hardware limita o tamanho do modelo
- Instalação pessoal, sem várias contas
Assistentes na nuvem
Vantagens
- Funcionam sem instalação
- Dão acesso a modelos muito grandes
Limites
- A conversa é processada em servidores externos
- Podem ter custos recorrentes
- Seguem as regras e os recursos do serviço
Em construção agora: notas fiscais e memória
Importação de notas fiscais com RAG
Neste momento estou implementando RAG (geração aumentada por recuperação) para importar notas fiscais. O objetivo é que a Aura leia uma nota e leve para o histórico de compras a loja, a data, os itens, as quantidades e os preços.
A regra de segurança não muda: nada vira compra sem eu revisar e confirmar antes de salvar.
Memória semântica do makesluke
O makesluke já tem hoje uma memória semântica funcionando. A Aura ainda não a usa. O próximo passo é conectar a Aura a essa memória, para que ela deixe de depender só do histórico de conversas guardado no PostgreSQL.
As ações que alteram dados continuam passando por regras fixas, com recibo.
Status do projeto: o que funciona e o que falta
| Recurso | Estado | Observação |
|---|---|---|
| Conversa por texto e voz | Implementado | Falta validar microfone, voz e avatar em outros aparelhos |
| Lista de compras e catálogo | Implementado | Código pronto; falta confirmar a migração e os fluxos com o PostgreSQL em execução |
| Scanner de códigos de barras | Em validação | Teste em celulares e navegadores pendente; a digitação manual funciona |
| Clima e estado do computador | Implementado | Somente leitura |
| Painel de agentes e resumo do dia | Parcial | Mostra a fila; ainda não existe executor de tarefas |
| Importação de notas fiscais (RAG) | Em andamento | Sempre com revisão antes de salvar a compra |
| Memória semântica (makesluke) | Planejado | A memória já existe; falta conectar a Aura |
| Histórico de compras | Planejado | Por loja, data e preço, alimentado pela importação |
| Várias contas | Planejado | Dados separados por usuário |
Próximos passos
- Concluir a importação de notas fiscais com RAG, com revisão e confirmação antes de salvar.
- Conectar a Aura à memória semântica do makesluke.
- Confirmar o banco de dados em funcionamento e validar os fluxos de lista e catálogo com dados reais.
- Conectar a fila de tarefas a um executor autorizado.
- Separar os dados por usuário antes de aceitar mais contas.
Perguntas frequentes
A Aura envia minhas conversas para a nuvem?
Não. A conversa vai para um modelo que roda na minha máquina com o Ollama, e o histórico fica no PostgreSQL local. As exceções são o clima, que consulta a Open-Meteo, e o download inicial do modelo de voz.
Qual modelo de IA a Aura usa?
A conversa livre usa o Nemotron 8B, quantizado e executado pelo Ollama na memória RAM do notebook. O modelo é definido por configuração, o que permite trocar de modelo sem mudar o resto do sistema.
A IA executa as ações, como remover um item da lista?
Não. O modelo só conversa. As ações são reconhecidas por regras fixas e executadas pelo backend, que responde com um recibo.
A Aura tem memória de longo prazo?
Hoje ela guarda o histórico das conversas no PostgreSQL local. O makesluke já tem uma memória semântica funcionando, mas a Aura ainda não está conectada a ela. Conectar as duas é um dos próximos passos.
A transcrição de voz precisa de placa de vídeo?
Não. Na máquina real da Aura, um notebook com Intel Core i7 de 7ª geração, 16 GB de RAM e uma GeForce 940MX de 2 GB, todo o áudio roda na CPU: o Vosk e o faster-whisper (modelo small, quantização int8). Os 2 GB de VRAM não comportam o Whisper na GPU, e a transcrição em CPU atende ao uso pessoal.
Preciso de um computador potente para rodar uma IA local como a Aura?
Não necessariamente. A Aura roda em um notebook com Intel Core i7 de 7ª geração, 16 GB de RAM e uma GeForce 940MX de 2 GB. O custo é a latência: o estado "pensando" demora mais porque a CPU divide o trabalho entre áudio e modelo. Hardware melhor reduz esse tempo, mas não é pré-requisito.
Posso usar a voz da Aura em um projeto comercial?
A voz padrão usa o Phonon, com licença CC BY-NC 4.0, que não permite uso comercial. Em um produto comercial seria preciso trocar a voz ou obter uma licença adequada.
A Aura funciona para mais de uma pessoa?
Ainda não. A instalação atual é pessoal e os dados não são separados por usuário.
Conclusão
A Aura mostra um caminho prático para um assistente de IA local: o modelo cuida da conversa, e regras fixas cuidam das ações. Com isso, ela responde em português, fala, mostra o que está fazendo e confirma cada alteração com um recibo.
O projeto segue em desenvolvimento. Agora estou importando notas fiscais com RAG, e em seguida vou conectar a Aura à memória semântica do makesluke.
What is Aura?
Aura is a local AI assistant in Portuguese, with a visual interface, voice and an animated avatar. I built it to help with everyday tasks and to test, in practice, how to combine a local language model with a system that carries out real actions.
It runs entirely on my machine: the interface in React, the API in Python and the data in PostgreSQL. Conversation uses Ollama, which runs the language model locally.
At a glance
- Status
- In development
- Runs on
- My own computer
- Language
- Portuguese
- Interface
- Voice, text and animated avatar
- Conversation
- Ollama, quantized Nemotron 8B
- Data
- PostgreSQL
Main features
- Conversation by text or voice, in Portuguese
- Spoken answers, with an avatar that follows the speech
- Shopping list and product catalog with barcodes
- Weather, computer status and a daily summary
- Actions carried out by fixed rules, each with a receipt
- Data kept in a local PostgreSQL database
Why build a local assistant?
Three reasons led me to build Aura instead of using an off-the-shelf assistant.
- Privacy. The conversation goes through a model running on my machine and is saved in my own database.
- Control. I decide what the assistant can do, and every action goes through code I write and test.
- Learning. Building the whole system, from voice to database, shows where an AI assistant works well and where it needs limits.
If you want to set up the base of a local AI, see What Ollama is and how to install it (in Portuguese).
What Aura does today
Conversation by text and voice
I can type or speak. Free conversation goes to the local model, and the history is saved in PostgreSQL, tied to my account.
Shopping list
I ask to add or remove an item, by name or by number, and Aura does it. If the request is incomplete, it asks which item I mean. The screen lets me remove items with confirmation and export the list as a PDF. The video at the top of the page shows this flow.
Product catalog and barcodes
- Search by name, brand, category and nicknames
- Variants and package sizes for each product
- Barcode scanner using the phone camera, with manual entry as a fallback
- Barcodes are never deleted, only deactivated
- If I add a product that is not in the catalog, Aura asks whether to create it and only saves after a "yes"
Weather
Shows current conditions and a three-day forecast, with temperature, feels-like temperature, humidity and wind. The data comes from Open-Meteo, and location is only requested when needed.
Computer status
A read-only panel shows processor, memory, disk, uptime and the NVIDIA graphics card, when there is one. It does not list processes or show secret settings.
Agents and daily summary
A panel shows recent agents and tasks, with status (queued, running, finished or failed) and progress. The daily summary is spoken: Aura says what is running and what is waiting in the queue. There is no executor yet that runs these tasks on its own, and that is on the to-do list.
Voice and face: how Aura listens and speaks
How it listens
Audio goes first to Vosk, which transcribes Portuguese. When the speech is free-form, is not recognized or needs confirmation, faster-whisper steps in (small model, on CPU with int8). For actions that change data, both transcriptions must agree. If they disagree, Aura does not act.
How it speaks
The answer is synthesized locally with Phonon, in the Portuguese voice Isadora, with Piper as a fallback. Before speaking, the text goes through a validator that prepares numbers, percentages, dates and times for pronunciation, without changing what appears on screen.
The Phonon license (CC BY-NC 4.0) does not allow commercial use, so this voice is for personal use.
The avatar
The face is an SVG drawing, with visual states such as away and idle, and it follows voice playback. Before opening a screen, Aura announces what it is about to do. After showing the result, it reads a summary.
The model talks, the code acts
This is the central decision of the project. The language model does not run tools and does not access the database. Requests such as adding or removing an item are recognized by fixed rules and carried out by the backend, which validates the request and returns a receipt: done, nothing changed, or item not found.
I speak or type
   │
   ├─ Action request (list, catalog, weather, system)
   │     └─ Fixed rules → backend validates → PostgreSQL → receipt → Aura narrates
   │
   └─ Free conversation
         └─ Ollama (local model) → spoken answer
Why not let the model carry out the actions?
- The result is predictable: the same request produces the same action.
- Each action can be validated and tested like any other code.
- Aura never says it did something that did not happen, because the answer comes from the backend receipt.
- Actions that create data, such as registering a product, require explicit confirmation.
The model stays in charge of free conversation.
Architecture and technologies
Aura
 ├── Interface   React 18 + Vite, SVG avatar
 ├── API         Python + FastAPI
 ├── Data        PostgreSQL
 ├── Chat        Ollama (quantized Nemotron 8B, in RAM)
 ├── Voice       Vosk + faster-whisper (input), Phonon + Piper (output)
└── Weather Open-Meteo| Layer | Technology | Role |
|---|---|---|
| Interface | React 18 and Vite | Screens, SVG avatar and narration |
| API | Python and FastAPI | Endpoints, validation and action rules |
| Data | PostgreSQL | List, catalog, conversations and tasks |
| Conversation | Ollama with quantized Nemotron 8B | Local language model, run in system RAM |
| Voice input | Vosk and faster-whisper | Portuguese transcription, 100% on CPU (int8) |
| Voice output | Phonon and Piper | Local speech synthesis |
| Weather | Open-Meteo | Current conditions and forecast |
The products module follows well-separated layers: routes, controllers, services and repositories. Each layer only talks to the next one.
Real hardware: a laptop with a 2 GB GPU
Everything you see in the video runs on an ordinary laptop, with no server and no modern graphics card. It is worth showing the machine and explaining what it imposed on the project, because several of Aura's decisions came from these limits.
Specifications
- Processor
- 7th-generation Intel Core i7, 4 cores and 8 threads
- RAM
- 16 GB DDR4
- Operating system
- Ubuntu Linux
- GPU
- NVIDIA GeForce 940MX, 2 GB of VRAM (legacy architecture)
What the hardware decided
| Task | Hardware limit | Decision in Aura |
|---|---|---|
| Voice transcription | 2 GB of VRAM cannot hold Whisper on the GPU | Vosk and faster-whisper (small model, int8 quantization), 100% on the CPU |
| Free conversation | The GPU cannot hold an 8-billion-parameter model | Quantized Nemotron 8B, run by Ollama in system RAM |
| Speech synthesis | No GPU left for other workloads | Phonon and Piper, local, sharing the CPU |
In short: the 2 GB GPU stays out of the AI pipeline, and the CPU with 16 GB of RAM does all the work. Quantization is what makes this viable. A quantized 8-billion-parameter model takes a few gigabytes and fits in system memory, and faster-whisper in int8 cuts the cost of transcription on the CPU.
Why Aura takes a while in the "thinking" state
In the video demo, there is a visible pause in the "thinking" state. It is not an editing effect or a code bug: it is CPU contention. Transcription, the language model and speech synthesis compete for the same 4 cores, and free conversation is the heaviest step. Actions such as editing the shopping list go through fixed rules, without the model, so they are fast.
I prefer to show this latency as it is. It shows that a private AI assistant, in Portuguese and with a voice, does not require a cluster, a dedicated server or an expensive graphics card. Better hardware would make Aura faster, but the project works without it.
Security and privacy
Aura has its own login. Passwords are stored with an Argon2 hash, the session expires after eight hours and can be ended by logging out. Requests that change data require a token against forged requests, and the logs do not keep speech content or secret settings.
What leaves my machine
The conversation and the data stay local. There are two exceptions: the weather, which queries Open-Meteo with the browser's coordinates, and the first download of the voice model, which needs access to Hugging Face.
Built for one person
The current setup is personal. The list and the tasks are not yet separated by user, so Aura is not ready for multiple accounts.
Local AI or a cloud assistant?
Aura (local)
Advantages
- Conversation and data stay on my machine
- I control what each action does
- Made for my workflow, in Portuguese
Limits
- Requires installation and maintenance
- Hardware limits the model size
- Personal setup, no multiple accounts
Cloud assistants
Advantages
- Work without installation
- Give access to very large models
Limits
- The conversation is processed on external servers
- May have recurring costs
- Follow the rules and features of the service
Being built now: receipts and memory
Importing receipts with RAG
Right now I am implementing RAG (retrieval-augmented generation) to import receipts (notas fiscais). The goal is for Aura to read a receipt and bring the store, the date, the items, the quantities and the prices into the purchase history.
The safety rule does not change: nothing becomes a purchase until I review and confirm it before saving.
makesluke's semantic memory
makesluke already has a working semantic memory today. Aura does not use it yet. The next step is to connect Aura to that memory, so it no longer depends only on the conversation history kept in PostgreSQL.
Actions that change data keep going through fixed rules, with a receipt.
Project status: what works and what is missing
| Feature | Status | Notes |
|---|---|---|
| Text and voice conversation | Implemented | Microphone, voice and avatar still need testing on other devices |
| Shopping list and catalog | Implemented | Code is ready; the migration and flows still need confirming with PostgreSQL running |
| Barcode scanner | In validation | Testing on phones and browsers pending; manual entry works |
| Weather and computer status | Implemented | Read-only |
| Agents panel and daily summary | Partial | Shows the queue; there is no task executor yet |
| Receipt import (RAG) | In progress | Always with review before saving the purchase |
| Semantic memory (makesluke) | Planned | The memory already exists; Aura still needs to be connected |
| Purchase history | Planned | By store, date and price, fed by the import |
| Multiple accounts | Planned | Data separated by user |
Next steps
- Finish the receipt import with RAG, with review and confirmation before saving.
- Connect Aura to makesluke's semantic memory.
- Confirm the database is running and validate the list and catalog flows with real data.
- Connect the task queue to an authorized executor.
- Separate data by user before accepting more accounts.
Frequently asked questions
Does Aura send my conversations to the cloud?
No. The conversation goes to a model running on my machine through Ollama, and the history stays in the local PostgreSQL. The exceptions are the weather, which queries Open-Meteo, and the initial download of the voice model.
Which AI model does Aura use?
Free conversation uses Nemotron 8B, quantized and run by Ollama in the laptop's RAM. The model is set by configuration, so I can change models without touching the rest of the system.
Does the AI carry out actions, like removing an item from the list?
No. The model only talks. Actions are recognized by fixed rules and carried out by the backend, which answers with a receipt.
Does Aura have long-term memory?
Today it keeps the conversation history in the local PostgreSQL. makesluke already has a working semantic memory, but Aura is not connected to it yet. Connecting the two is one of the next steps.
Does voice transcription need a graphics card?
No. On Aura's real machine, a laptop with a 7th-generation Intel Core i7, 16 GB of RAM and a 2 GB GeForce 940MX, all audio runs on the CPU: Vosk and faster-whisper (small model, int8 quantization). The 2 GB of VRAM cannot hold Whisper on the GPU, and CPU transcription is enough for personal use.
Do I need a powerful computer to run a local AI like Aura?
Not necessarily. Aura runs on a laptop with a 7th-generation Intel Core i7, 16 GB of RAM and a 2 GB GeForce 940MX. The cost is latency: the "thinking" state takes longer because the CPU splits its time between audio and the model. Better hardware shortens it, but is not a requirement.
Can I use Aura's voice in a commercial project?
The default voice uses Phonon, licensed CC BY-NC 4.0, which does not allow commercial use. A commercial product would need a different voice or a proper license.
Does Aura work for more than one person?
Not yet. The current setup is personal and data is not separated by user.
Conclusion
Aura shows a practical path to a local AI assistant: the model handles the conversation, and fixed rules handle the actions. With that, it answers in Portuguese, speaks, shows what it is doing and confirms every change with a receipt.
The project is still in development. I am now importing receipts with RAG, and next I will connect Aura to makesluke's semantic memory.